
Éditorial
Construire une grille de QA anti-détection IA
Les taux de précision publiés par les détecteurs IA se contredisent d'une source à l'autre. La grille de QA éditoriale et le gabarit de scoring pour juger un contenu sans s'y fier.
Éditorial · Production IA
Ce que Google sanctionne vraiment dans le contenu IA à l'échelle, et ce que révèle un audit interne de 14 contenus sur le vrai risque EEAT.
Produire du contenu IA à l'échelle n'est pas ce que Google sanctionne : il sanctionne l'absence de supervision et de valeur ajoutée. OMKomUnity a testé ce principe sur son propre terrain, avec un audit de 14 contenus pédagogiques propriétaires affichant un EEAT contenu IA moyen à 6,1 sur 10. La preuve la plus solide qu'une agence peut apporter n'est pas une checklist de plus : c'est un audit qu'elle a elle-même subi.
Produire du contenu IA à l'échelle inquiète, en partie à raison, mais rarement pour les bonnes raisons. Google Search Central l'écrit noir sur blanc dans sa documentation sur le contenu utile, mise à jour le 5 octobre 2026 : générer des pages depuis des flux, ou utiliser de l'IA générative pour produire du texte en masse sans supervision ni curation humaine, représente peu ou aucun effort réel. Ce n'est pas l'IA qui pose problème ici. C'est l'absence de supervision.
La même page pose un triptyque qui structure le reste : Who, How, Why. Qui a écrit ce contenu, est-ce évident pour le visiteur ? Comment a-t-il été produit, est-ce documenté pour que le lecteur comprenne le rôle de l'automatisation ? Pourquoi a-t-il été créé : la réponse est-elle « pour aider les gens », ou autre chose ?
Ce triptyque trouve son miroir répressif dans les politiques anti-spam de Google, mises à jour le 28 août 2026 : l'abus de contenu à l'échelle, des pages générées dans le seul but de manipuler le classement, sans aider l'utilisateur. L'IA générative y figure parmi les méthodes couvertes, à égalité stricte avec le scraping automatisé. Un comportement visé, jamais un outil.
Angle moins connu : la documentation « Using generative AI content » de Google Search Central, mise à jour au 1er octobre 2026, dit l'inverse de ce qu'on redoute. Partager comment un contenu a été créé aide le lecteur à mieux le situer ; l'IA générative devient même utile pour la recherche documentaire ou pour structurer un contenu original, un usage légitime nommé comme tel par Google.
Ce que Google sanctionne, en clair :
Ce que Google ne sanctionne pas :
La méthode de production n'est jamais le critère, qu'il s'agisse du contenu généré par IA et SEO ou de tout autre format : seule la valeur ajoutée l'est, et c'est elle qui distingue les points de contrôle d'une production à l'échelle qui restent défendables de ceux qui ne le sont pas. Ce qui menace la crédibilité contenu IA, ce n'est jamais l'outil. C'est l'absence de supervision derrière lui.
L'EEAT, ou E-E-A-T Google selon l'écriture retenue par ses propres guidelines, est un cadre d'évaluation de la qualité en quatre lettres : Expérience, le vécu direct d'une situation ; Expertise, la compétence réelle sur le sujet ; Autorité, la reconnaissance par les pairs ou la profession ; Fiabilité, l'exactitude et la transparence des sources. Les évaluateurs humains mandatés par Google s'appuient sur les Quality Rater Guidelines pour juger si un contenu aide réellement un lecteur, au-delà de sa simple exactitude technique : un référentiel d'évaluation, pas un mécanisme de classement automatique.
Le deuxième E, Expérience, n'a pas toujours existé sous cette forme : Google l'a ajouté en décembre 2022, transformant l'EAT historique en EEAT. Un contenu peut être expert sur le papier sans jamais avoir été vécu par son auteur.
C'est ce point qui résiste le plus à une production purement automatisée. L'Expertise se reconstitue, en partie, à partir d'un corpus de connaissances. L'Expérience, non : elle suppose un vécu direct, avoir manipulé l'outil, avoir essuyé l'échec, avoir observé le résultat de ses propres yeux. Un système génératif peut décrire une expérience. Il ne peut pas en avoir une.
Dès février 2023, Google précisait sur son propre blog Search Central : l'attention de Google porte sur la qualité du contenu, pas sur la façon dont il a été produit. Un message qui recoupe le triptyque Who/How/Why vu plus haut et légitime la production assistée par IA tant que la qualité reste vérifiée. Pas l'outil. Le résultat.
Voici la partie qu'OMKomUnity aurait pu garder pour elle : la preuve chiffrée de son propre niveau d'EEAT contenu IA.
Quatorze contenus pédagogiques propriétaires (des leçons de formation internes, jamais une prestation client) ont été soumis à un audit de relecture indépendant le 8 septembre 2026. Chaque leçon a reçu un score global et un sous-score EEAT/Sourcing distinct. Ce sous-score est un indicateur interne et propriétaire d'OMKomUnity, pas un score officiel Google d'EEAT, lequel n'existe pas sous une forme chiffrée publique. Voici le résultat, leçon par leçon.
| Leçon (palier du parcours) | EEAT/Sourcing /10 | Score global /10 |
|---|---|---|
| Novice 1 | 7,0 | 7,9 |
| Novice 2 | 5,0 | 7,7 |
| Novice 3 | 7,0 | 8,0 |
| Novice 4 | 5,0 | 7,9 |
| Avancé 1 | 6,0 | 7,6 |
| Avancé 2 | 6,0 | 8,0 |
| Avancé 3 | 6,5 | 8,1 |
| Avancé 4 | 5,0 | 7,6 |
| Avancé 5 | 6,5 | 7,9 |
| Expert 1 | 6,0 | 8,5 |
| Expert 2 | 6,5 | 8,4 |
| Expert 3 | 6,5 | 7,8 |
| Expert 4 | 6,0 | 7,8 |
| Expert 5 | 6,5 | 8,3 |
| Moyenne | 6,1 | 8,0 |
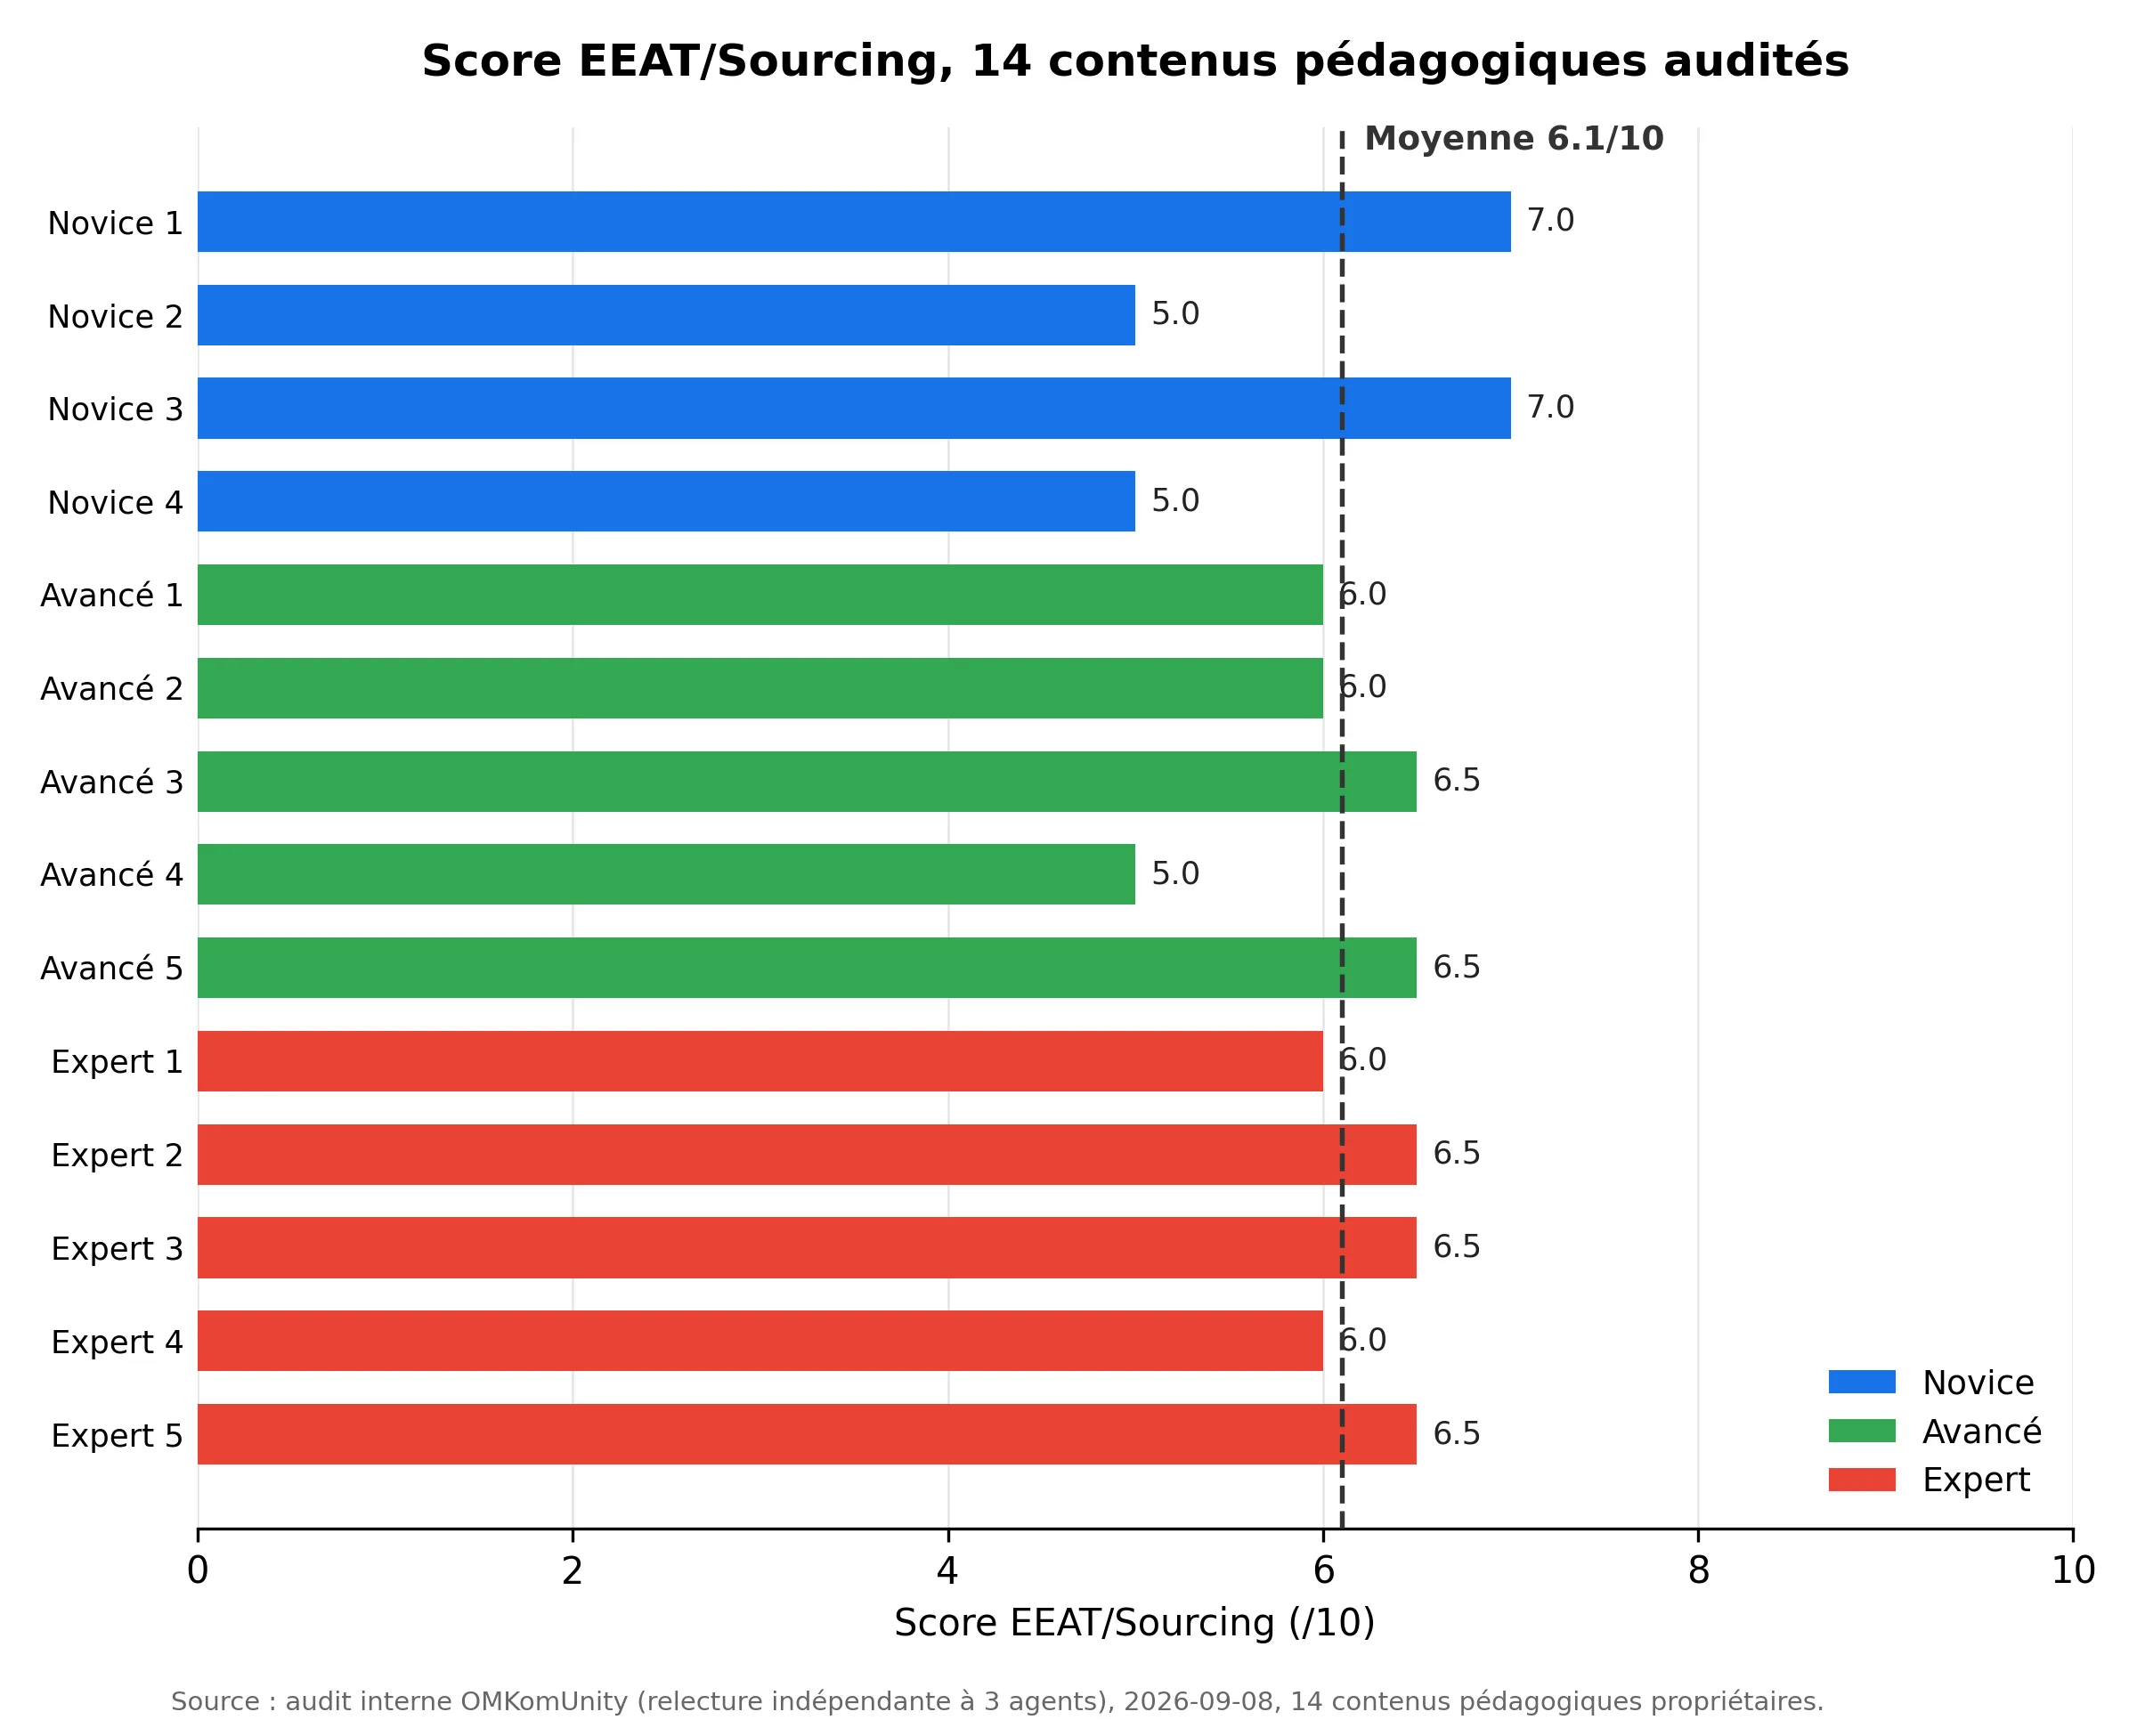 Source : audit interne OMKomUnity (relecture indépendante à 3 agents), 2026-09-08, 14 contenus pédagogiques propriétaires.
Score global moyen : 8,0 sur 10. Correct. Mais la dimension EEAT/Sourcing, elle, plafonne nettement plus bas : 6,1 sur 10 en moyenne, avec une plage allant de 5,0 à 7,0 selon les leçons. Un écart de presque deux points entre la qualité perçue globale et la seule dimension qui mesure la traçabilité des affirmations. Ce n'est pas un hasard de calcul. C'est un plafond structurel, et il a une cause identifiée.
Le constat de l'auditeur, en substance : un avis « d'après notre expérience » ne peut pas être sourcé par une URL externe sans inventer un client ou une étude qui n'existe pas. La seule correction rigoureuse consiste à le requalifier comme un avis assumé, ce qui plafonne mécaniquement cette dimension autour de 5 à 7 sur 10 pour un site d'agence sans étude de cas publique chiffrée.
Ce schéma se répète dans les 14 rapports, sans exception. Un exemple concret, tiré d'une des leçons avancées : une phrase affirme que « la cause la plus fréquente d'incidents en production reste le code qui ne gère pas les erreurs », présentée comme un constat tiré de l'expérience d'audit de l'agence. Aucun chiffre. Aucune période. Aucun nombre d'audits cité. L'affirmation sonne crédible. Elle n'est pas vérifiable.
Un autre cas, plus révélateur encore, montre que le problème n'est pas que statistique : il est aussi de cohérence éditoriale. Une leçon donne un montant de budget mensuel en l'attribuant deux fois à « l'expérience terrain de l'équipe », puis invite le paragraphe suivant à se méfier des chiffres d'agence non sourcés. Sans jamais reconnaître qu'elle vient d'en fournir un elle-même. La posture éditoriale doit être cohérente avec elle-même, pas seulement correcte sur le papier.
Ce plafond de 6,1 sur 10 n'est pas un verdict à charge uniforme. Deux contre-exemples, dans le même corpus, illustrent qu'on peut faire autrement.
Premier cas : une leçon sur la sécurité et les permissions mobilise un sourcing institutionnel rigoureux et daté, avec la CNIL, une déclaration nominative via FrenchWeb en 2024, et le centre de confidentialité d'Anthropic. Chaque affirmation sensible y est rattachée à un organisme identifiable, pas à une impression d'équipe. Preuve que le plafond ne porte pas sur l'ensemble du contenu, mais spécifiquement sur les affirmations d'expérience propriétaire invérifiables.
Second cas, tout aussi instructif : une leçon présente les métriques d'un run interne en les attribuant explicitement à « l'équipe pédagogique OMKomUnity, août 2026 », avec un encadré de non-représentativité assumé. Ce n'est pas une source nominative stricte. Mais l'auditeur l'accepte comme une bonne pratique dégradée, parce qu'elle assume sa propre limite au lieu de la dissimuler. À l'inverse, un chiffre isolé, laissé sans aucun garde-fou dans la même leçon, reste pénalisé. La différence ne tient pas à la nature du chiffre. Elle tient à ce qu'on en dit. Une autre leçon du même corpus applique déjà ce réflexe en amont, sur un terrain moins sensible : elle qualifie explicitement une recommandation d'« avis de l'agence OMKomUnity, pas une règle documentée par Anthropic », avant même d'aborder la sécurité ou les métriques internes.
De ce constat découle une méthode transférable, en deux temps.
Premier temps : toute affirmation chiffrée ou factuelle doit pouvoir se tracer jusqu'à un organisme nommé, une date, une URL. Pas une impression, pas « les études montrent », mais « Google Search Central, mise à jour du 5 octobre 2026, le confirme ». Une référence qu'un lecteur peut vérifier lui-même, en cliquant.
Second temps, le plus souvent négligé : ce qui ne peut pas être tracé de cette façon doit être requalifié explicitement comme un avis, jamais habillé en fait. Cette discipline simple sépare la crédibilité contenu IA d'une production qui en a seulement l'apparence. Un avis signé « selon notre expérience » n'est pas un problème en soi, à condition qu'il soit présenté comme tel, et non maquillé en donnée vérifiable indépendamment.
Cette discipline ne se décrète pas en relecture, une fois le texte terminé : elle se cadre en amont, en apprenant à rédiger un brief éditorial exploitable avant de lancer la production, là où se décide, pour chaque affirmation prévue, si elle sera un fait sourcé ou un avis assumé. Le sourcing contenu IA n'est pas une étape de correction : c'est une architecture qu'on pose avant d'écrire la première phrase.
Il faut distinguer deux risques, et ils ne pèsent pas pareil. Un avis d'agence assumé comme tel coûte des points sur le sous-score EEAT, mais il reste clair pour le lecteur : il dit ce qu'il est.
La fausse autorité est d'une autre nature. Dans le même corpus de 14 leçons, un cas a été détecté puis corrigé : une leçon affirmait qu'un mécanisme technique précis était documenté officiellement par un fournisseur, alors que seule une partie de ce mécanisme l'était réellement. L'erreur a été vérifiée, puis corrigée dans les six endroits concernés du texte.
Ce cas pèse plus lourd qu'un avis non sourcé, pour une raison simple : il ne se contente pas de manquer de preuve, il trompe activement. Un lecteur qui fait confiance à une attribution d'autorité officielle prend une décision sur une base fausse, sans aucun moyen de le savoir au moment de la lecture. C'est le signal le plus dangereux que peut porter un contenu produit à l'échelle, bien plus qu'un simple déficit de sourcing contenu IA. Les signaux d'un contenu IA non relu se logent précisément là : moins dans l'absence de preuve que dans l'excès de confiance mal placé.
Une méthode ne vaut que si elle devient un contrôle reproductible, pas une bonne intention relue une fois par trimestre.
C'est précisément ce que couvre la grille de QA anti-détection IA, un outil construit pour vérifier, systématiquement et avant publication, qu'un contenu applique cette discipline fait/avis plutôt que de la revendiquer sans la tenir. Elle traduit en points de contrôle concrets tout ce qui vient d'être décrit : sourcing traçable, avis requalifiés, fausses autorités détectées avant publication, pas après.
Produire à l'échelle sans ce garde-fou revient à parier que personne ne vérifiera. Avec, la vérification devient un processus, pas un pari. Le pilier éditorial d'OMKomUnity regroupe l'ensemble de cette approche : comment produire beaucoup sans jamais sacrifier ce qui rend un contenu vérifiable.
Revenons à l'ouverture.
La dernière mise à jour confirmée des Quality Rater Guidelines date du 11 septembre 2025, rapportée par Search Engine Roundtable (média spécialisé fiable sur ce terrain, mais source secondaire, pas Google elle-même) : document passé de 181 à 182 pages, sur les définitions YMYL et l'ajout d'exemples d'évaluation pour les AI Overviews. Rien n'y concerne une refonte de l'attribution d'auteur humain ni un quelconque concept d'autorité synthétique.
Et pourtant, une rumeur non confirmée de mise à jour prévue en mai ou juin 2026 circule sur une dizaine de blogs SEO commerciaux tiers, un cas d'école daté du jour même. Les sources qui la portent se contredisent sur la date exacte et donnent surtout deux noms différents, aux sens quasiment opposés, au même concept non confirmé : « Synthesized Authority » en connotation positive, « Synthetic Authority » en connotation négative. Aucune ne cite la documentation Google elle-même, et une vérification croisée sur le blog officiel de Search Central, sur Search Engine Land et sur Search Engine Roundtable ne corrobore rien de tout cela.
Cette rumeur n'est pas un fait. Elle est non confirmée, et le restera tant qu'aucune source primaire Google ou média SEO de référence ne la reprendra avec une preuve directe. La traiter comme acquise reviendrait à commettre, sur l'EEAT contenu IA même, exactement l'erreur dénoncée plus haut : une affirmation sans traçabilité, habillée en fait.
Ce qui ne change pas, en revanche, c'est le principe de fond posé dès l'ouverture : Google juge la valeur ajoutée, pas la méthode de production. Les mises à jour des Quality Rater Guidelines affinent des critères d'évaluation ; elles n'ont pas modifié cette ligne de fond à ce jour, et aucune rumeur non corroborée ne devrait faire croire le contraire.
L'E-E-A-T Google, ou EEAT, est un cadre d'évaluation de la qualité (Expérience, Expertise, Autorité, Fiabilité) auquel se réfèrent les évaluateurs humains des Quality Rater Guidelines de Google pour juger si un contenu aide réellement le lecteur.
Pas pour son origine. Google cible l'absence de supervision ou de curation et l'intention de manipuler le classement, pas la méthode de production elle-même.
Parce qu'elle suppose un vécu direct, pas une compétence généraliste reconstituée à partir d'un corpus d'entraînement.
En distinguant systématiquement ce qui est sourcé (organisme, date, URL) de ce qui relève d'un avis d'expérience assumé comme tel.
Oui, s'il est présenté comme tel et jamais comme un fait vérifiable indépendamment. Non, s'il est habillé en donnée chiffrée sans source.
Le premier reste clair sur sa nature. La seconde attribue à tort un mécanisme ou une règle à une source officielle qui ne la documente pas réellement.
Non, si elles sont vérifiées à la source. La dernière confirmée date de septembre 2025 ; les rumeurs non corroborées par Google ou un média de référence ne doivent jamais être traitées comme des faits.
Produire à l'échelle n'est pas le risque EEAT. Produire sans discipline de sourcing l'est, avec ou sans IA dans la boucle. Un rédacteur humain qui invente un chiffre pour étayer son propos commet exactement la même faute qu'un système génératif mal supervisé. L'outil n'a jamais été la variable qui compte.
L'audit interne décrit ici en offre une démonstration directe : 6,1 sur 10 en moyenne sur la dimension EEAT/Sourcing, un plafond structurel identifié, deux contre-exemples qui illustrent qu'on peut faire mieux sans renoncer à la vitesse de production. La discipline qui corrige ce plafond tient en une règle courte. Un fait se source. Un avis s'assume. Jamais l'inverse.
Cadrer cette discipline de sourcing avant de produire, pas après, c'est le travail qu'OMKomUnity mène avec les équipes éditoriales qui veulent sécuriser leur EEAT contenu IA sans renoncer à la vitesse de production.
Cette formation fait partie du parcours Éditorial at-scale de l'academy SEO/GEO d'OMKomUnity, qui recense toutes les formations déjà publiées.
L'auteur
Erlé Alberton
Fondateur de OMKomUnity. Pilote agence et conseil sur SEO, GEO, architecture martech et orchestration IA marketing — studio pour l'exécution, expertise personnelle pour le cadrage, sans complexité inutile ni surcoût structurel.
Pour continuer
Une sélection, pas un flux : ce qui change quelque chose, et pourquoi.
À lire aussi
Les taux de précision publiés par les détecteurs IA se contredisent d'une source à l'autre. La grille de QA éditoriale et le gabarit de scoring pour juger un contenu sans s'y fier.
Le vrai risque n'est pas l'absence de brief, c'est le faux brief : une commande qui a l'air cadrée mais laisse les décisions structurantes à qui rédige.
Un contrat de production éditoriale en marque blanche est, légalement, un contrat de sous-traitance : les droits, les délais et le contrôle qualité à vérifier avant de signer avec une agence partenaire SEO.
Nous utilisons des traceurs de mesure d’audience et de publicité. Vous pouvez les accepter, les refuser, ou choisir finalité par finalité — le site fonctionne identiquement dans tous les cas. En savoir plus