Le 19 août 2026, l'équipe d'ingénierie de Shopify publie sur son blog technique un article
intitulé « Gisting : compresser le contexte d'un agent LLM pour augmenter le débit et réduire
le coût ». La technique vise l'agent Sidekick, l'assistant conversationnel construit sur
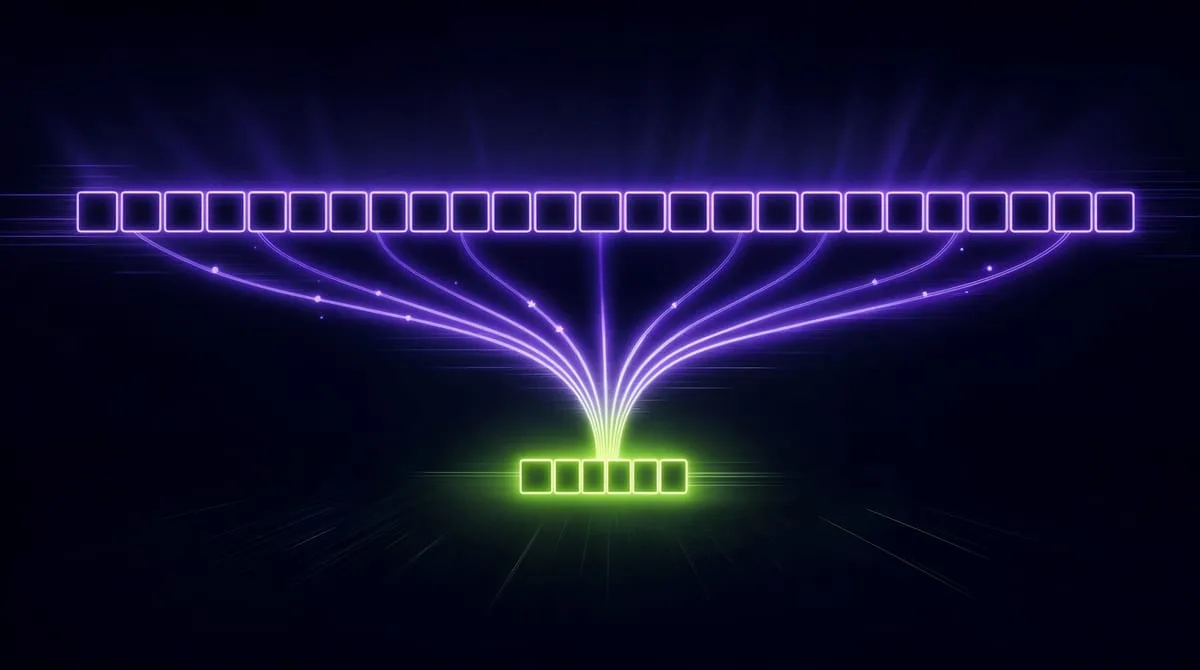
l'API GraphQL de Shopify : plutôt que d'envoyer à chaque requête un prompt système complet,
l'équipe entraîne des tokens spéciaux (des « gist tokens ») à porter la même information sous
forme condensée, par distillation de connaissance.
Les chiffres publiés par Shopify elle-même : le prompt système passe d'environ 6 000 tokens à
1 500 tokens (compression 4:1), le temps jusqu'au premier token (TTFT) baisse de 19 %, la
latence de bout en bout de 38 %, et le débit augmente de 16 %.
Le 1er septembre 2026, le PDG de Shopify Tobi Lütke publie sur X un message plus spécifique :
un modèle Qwen3.5 affiné de 0,8 milliard de paramètres surpasse GPT-5.6 Sol, réglé sur son
niveau de raisonnement le plus poussé, sur une tâche interne précise : la génération de
profils acheteurs pour ce même agent Sidekick, à partir des signaux de navigation, d'achat et
de panier.
Ce point n'apparaît pas dans l'article technique officiel de Shopify : il vient du post de
Tobi Lütke lui-même, puis a été repris et détaillé par plusieurs relais : notamment la
newsletter AI Fire (5 septembre) et le digest technique Code Gully (6 septembre), qui
chiffrent la baisse du prompt système correspondant (de 9 100 à 1 100 tokens) et une hausse du
débit de 2 à 72 millions de profils générés par jour. Code Gully avance aussi un coût de
service estimé : environ 27 millions de dollars par an avec un modèle de pointe généraliste,
contre environ 1 million avec le modèle spécialisé, un ordre de grandeur explicitement
présenté comme une estimation, pas une donnée de facturation communiquée par Shopify.
Les deux fils, l'article Gisting et le post de Tobi Lütke, décrivent le même principe de
fond : les échecs en production sont notés par des juges LLM calibrés sur des annotations
humaines, corrigés, puis réinjectés comme données d'entraînement pour un modèle spécialisé
moins cher. Un service à haut volume (jusqu'à 2 000 requêtes par minute selon Code Gully)
devient ainsi économiquement praticable sans faire tourner un modèle de pointe généraliste sur
chaque appel.