
GEO
Agences et outils GEO en France : le comparatif indépendant
21 agences et 3 outils de monitoring GEO en France, relevé du 15 octobre 2026 sur leur propre site : moteurs IA couverts, méthode, tarif. OMKomUnity inclus.
GEO · Méthode multi-moteurs
Une capture d'écran ne suffit pas : les réponses d'un moteur IA varient d'un tirage à l'autre. Un protocole reproductible en neuf étapes, pour ChatGPT, Perplexity, Claude, Gemini, Copilot et les fonctionnalités IA de Google.
Une capture d'écran ne suffit pas : les réponses d'un moteur IA varient d'un tirage à l'autre, et la visibilité IA qu'on en déduit varie avec elles. Voici un protocole reproductible (panier de requêtes, échantillonnage, niveaux mentionné/recommandé/sourcé), décliné pour ChatGPT, Perplexity, Claude, Gemini, Microsoft Copilot et les fonctionnalités IA de la recherche Google, pour transformer une impression en mesure.
Un audit GEO (generative engine optimization, soit l'optimisation de la visibilité d'une marque dans les réponses des moteurs et assistants IA) qui se limite à une capture d'écran montre une occurrence, pas une mesure. Une marque citée par ChatGPT dans un slide ne dit rien sur sa fréquence réelle de citation : juste qu'elle est apparue une fois, dans une exécution, à une date donnée.
J'ai posé la même question deux fois de suite à ChatGPT, dans deux sessions neuves, sans rien changer. J'ai obtenu deux réponses différentes : une marque citée dans la première, absente dans la seconde. Ce n'était pas un bug. C'était ma première rencontre avec une propriété que ChatGPT, Perplexity, Claude, Gemini, Copilot et les fonctionnalités IA de la recherche Google partagent tous, chacun selon sa propre mécanique documentée plus bas. Ce texte construit, moteur par moteur, un protocole qui en tient compte : une méthode, avec ses conditions de validité et ses zones encore floues.
Les prérequis techniques (un moteur peut-il seulement vous lire, vous citer, afficher une carte de résultat sérieuse) sont couverts ailleurs : voir le guide pour mesurer sa visibilité dans les moteurs génératifs. Ce texte les suppose acquis et se concentre sur le protocole qui vient après.
ChatGPT calcule une distribution de probabilités sur les prochains tokens possibles, puis tire une séquence dans cette distribution. Avec une température supérieure à zéro, plusieurs suites de mots restent plausibles à chaque étape : un principe général des modèles de langage, pas un paramètre que l'interface ChatGPT grand public expose directement. D'autres facteurs sont mieux documentés pour ChatGPT spécifiquement : le contexte et l'historique mémorisés (OpenAI documente cette personnalisation dans son centre d'aide), l'état du service, et, si la recherche web est activée automatiquement ou via la commande /Search, des données récupérées à cet instant précis. Deux requêtes identiques, à deux moments différents, n'ont donc aucune raison de produire le même résultat.
Cette source de variation change d'un système à l'autre, documentée par chaque éditeur (détail plus bas). Perplexity déclenche une recherche à chaque réponse standard, sans exception : la variabilité y vient presque exclusivement du web au moment de la requête. Claude et Gemini ajoutent une couche, la recherche ne se déclenchant jamais sans activation explicite côté développeur, et le défaut restant non tranché côté app grand public. Google AI Overviews, à l'inverse, s'affiche par défaut sans bascule de compte, seul un filtre « Web » par requête l'évite. Un protocole doit donc déclarer, pour chaque capture, comment la recherche a été obtenue, pas seulement sur quel moteur.
Une étude publiée le 15 décembre 2025 dans JMIR AI, en réinterrogeant ChatGPT, Gemini et Copilot à 1, 7 puis 14 jours d'intervalle sur des questions médicales, va à rebours de ce qu'on pourrait en attendre : les auteurs rapportent une bonne reproductibilité, coefficient de variation inférieur à 2 %, y compris quand la réponse initiale était erronée. Mesuré sur un protocole contrôlé et publié dans une revue à comité de lecture, ce résultat rappelle que le non-déterminisme de formulation coexiste, pour le contenu factuel répété, avec une forte stabilité.
Une capture montre seulement qu'une marque a été citée dans une exécution particulière, sans permettre de conclure à une visibilité systématique ou à son absence. Un préprint identifié par une référence arXiv correspondant à octobre 2025 qualifie cette variabilité de problème méthodologique de fond. Formulé au conditionnel tant que la littérature reste jeune, mais l'implication opérationnelle est solide : il faut agréger plusieurs tirages, dans des conditions déclarées. C'est l'objet des neuf étapes qui suivent.
« IA générative » n'est pas une catégorie unique du point de vue d'un protocole de mesure. Cinq mots recouvrent cinq réalités différentes, et les confondre change ce qu'on mesure.
Un assistant est l'application grand public : ChatGPT, l'app Gemini, Claude.ai, Copilot. Un modèle génère le texte sous-jacent et ne « cherche » jamais seul, c'est toujours une capacité ajoutée. Un moteur de recherche répond à une requête en renvoyant des résultats, avec ou sans IA. Une fonctionnalité est une capacité précise à l'intérieur d'un produit, comme « Grounding with Google Search » côté développeur Gemini, un terme absent de la doc d'aide grand public, qui ne parle que de « Sources ». Un mode est une expérience alternative choisie explicitement : Google AI Mode est un onglet conversationnel séparé, distinct de l'assistant Gemini et du résumé AI Overviews, qui lui s'affiche automatiquement au-dessus des résultats classiques.
Perplexity brouille volontairement cette grille : son centre d'aide la catégorise elle-même comme un « answer engine », distinct d'un moteur de recherche classique, avec la recherche et la citation comme mécanisme central et non désactivable de chaque réponse standard. C'est le seul des sept systèmes couverts ici où la citation est garantie par construction. Les six autres ont chacun une variable cachée, documentée officiellement par chaque éditeur :
| Système | Catégorie | Recherche web | Par défaut |
|---|---|---|---|
| ChatGPT | Fonctionnalité de l'assistant | Automatique ou manuelle | Hybride, non tranché par la doc |
| Perplexity | Moteur de réponse (catégorie propre) | Systématique | Oui, non désactivable |
| Claude | Outil développeur + option d'interface | Jamais sans activation (API) ; variable (app) | Activé au niveau organisation (API) ; variable (app) |
| Gemini | Fonctionnalité développeur + app | Jamais sans activation (API) ; non tranché (app) | Non (API) ; non documenté (app) |
| Microsoft Copilot | Assistant, nom en cours de fusion | Selon licence (entreprise) ; non tranché (grand public) | Variable selon licence |
| Google AI Overviews | Fonctionnalité de la recherche classique | Automatique sur requêtes concernées | Oui, non désactivable hors filtre Web |
| Google AI Mode | Mode de recherche à part | Oui, avec décomposition de la requête | Non, choisi par l'utilisateur |
Microsoft illustre bien pourquoi cette grille compte : Microsoft Learn documente, depuis une mise à jour du 18 août 2026, une fusion de nommage de « Microsoft 365 Copilot » (entreprise) vers « Microsoft Copilot », le même nom de produit recouvrant alors deux mécaniques de citation différentes selon la licence. Un protocole qui écrit juste « Copilot » sans préciser la licence mesure, dans les faits, un système ambigu.
Avant de choisir une plateforme, une question qu'un protocole statistique ne peut pas trancher pour soi : que cherche-t-on à savoir, et pour qui ?
Trois objectifs reviennent le plus souvent, chacun avec sa priorité de plateformes propre : suivre si la marque apparaît dans les comparatifs d'achat (audience grand public en phase de décision), suivre si elle est citée comme source d'autorité technique (audience de praticiens et développeurs), ou détecter une erreur factuelle récurrente, répétée moteur après moteur (audience qui rencontre la marque en creux, sans la chercher activement).
Un éditeur de CRM pour PME industrielles qui veut savoir s'il apparaît quand un acheteur demande « quel CRM choisir pour une petite équipe commerciale » vise une audience en phase de sélection : l'objectif est la présence dans un comparatif, pas l'autorité technique. Ce choix oriente directement l'étape suivante.
Livrable. Une fiche d'une page qui associe chaque objectif retenu à une ou deux audiences cibles, avec une phrase expliquant pourquoi. Cette fiche sert d'entrée à l'étape 2, elle n'a pas de valeur isolée.
Limites. Un objectif mal défini produit un protocole statistiquement rigoureux qui mesure la mauvaise chose ; ce n'est pas un problème que l'échantillonnage peut corriger après coup.
Insight. Un protocole statistiquement impeccable peut braquer sur la mauvaise audience si l'objectif n'a jamais été formulé avant de choisir les moteurs : l'échantillonnage ne corrige pas ce genre d'écart.
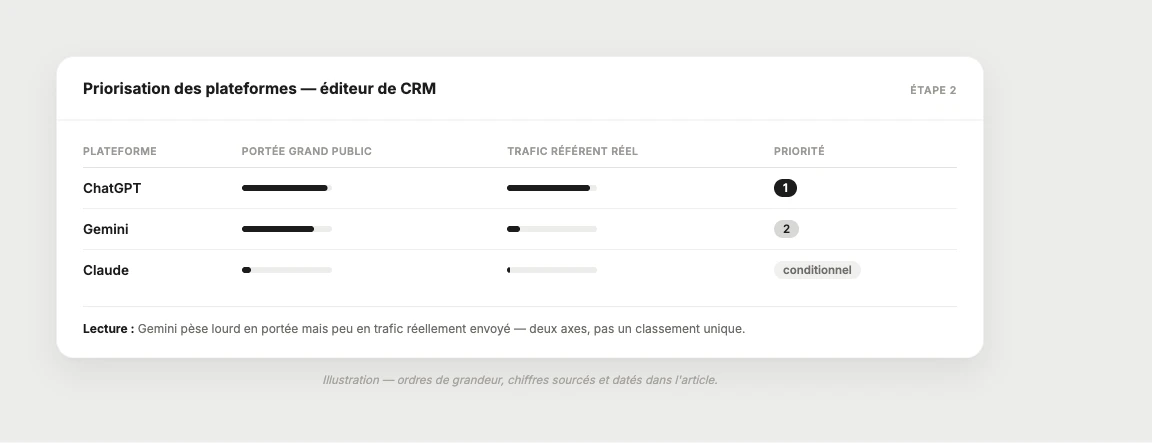
L'audience définie à l'étape précédente se croise avec des données d'adoption réelles, jamais un seul classement agrégé : aucun éditeur ne publie l'indicateur qui compterait vraiment, une part de requêtes sur base comparable, et les catégories disponibles (portée, usage professionnel, trafic référent) racontent des histoires différentes.
Sur la portée grand public, ChatGPT domine avec 1,2 milliard d'utilisateurs hebdomadaires (OpenAI, DevDay du 29 septembre 2026, mondial). Gemini suit avec 1 milliard d'utilisateurs mensuels (Google, 11 août 2026), décrit par Sundar Pichai comme le produit à la croissance la plus rapide de l'histoire de Google. Claude ne publie aucun chiffre grand public absolu : le seul signal, un panel tiers Similarweb, situe son audience mobile à 11,3 millions d'utilisateurs quotidiens au 2 mars 2026, un ordre de grandeur très inférieur. Perplexity revendique plus de 100 millions d'utilisateurs mensuels (estimation tierce Sacra, août 2026), une part significative provenant d'accords de distribution avec Airtel ou Snapchat, pas seulement de croissance organique.
Sur l'usage professionnel, le classement s'inverse presque : Claude affiche un positionnement B2B assumé par Anthropic (39 % des développeurs professionnels utilisaient Claude Code mi-2026, enquête JetBrains), Microsoft publiant des sièges payants Microsoft 365 Copilot en croissance continue sans jamais donner de chiffre grand public pur.
Sur le trafic référent, la mesure qui dit si une plateforme envoie vraiment du monde vers un site tiers, le classement change encore : une étude SE Ranking sur plus de 101 000 sites (18 juin 2026) attribue 74,78 % du trafic référent IA à ChatGPT, 11,56 % à Gemini, 7,23 % à Perplexity, 3,51 % à Copilot et 2,62 % à Claude. Gemini, malgré son milliard d'utilisateurs, ne pèse qu'un dixième de ce trafic : portée et trafic réellement envoyé sont deux questions distinctes.
Pour Google AI Overviews, jamais de part de requêtes publiée par Google ; les estimations tierces vont de 18 % (Pew Research, 22 juillet 2025, panel américain) à 86,7 % (Peec AI, 28 mai 2026, échantillon commercial non représentatif), un écart qui interdit tout chiffre fiable. Ce qui reste exploitable : AI Overviews s'affiche par défaut sur les requêtes concernées, ce qui crée une exposition mécanique (pas un résultat mesuré en soi) pour toute marque déjà bien positionnée sur la recherche Google classique.
Deux acteurs hors périmètre : Grok (117 millions d'utilisateurs via X, dépôt SpaceX, mars 2026 ; 244,9 millions de visites mensuelles en produit autonome grok.com, Similarweb, mai 2026) et DeepSeek (130 millions d'utilisateurs mensuels en Chine continentale, QuestMobile, mai 2026).
Pour l'éditeur de CRM, les plateformes prioritaires sont ChatGPT (priorité 1), Gemini (priorité 2), et Claude seulement si une part significative des acheteurs est technique. Google AI Overviews s'ajoute à part, avec une exposition quasi automatique indépendante de ce classement.
Livrable. Un tableau plateforme × axe (portée, B2B, trafic référent) × priorité, chaque chiffre daté et sourcé par son organisme d'origine.
Limites. Chaque chiffre cité ici porte sa propre date de publication, pas une photographie simultanée du marché. Au-delà de deux ou trois mois, il faut le rafraîchir avant de trancher une priorisation, pas le réutiliser tel quel.
Insight. Le chiffre qui fait la une (le nombre d'utilisateurs) et le chiffre qui compte pour une marque (le trafic référent qu'une plateforme lui envoie réellement) sont rarement corrélés : Gemini pèse onze fois plus en utilisateurs qu'en trafic référent relatif. Prioriser sur le seul volume d'utilisateurs revient à prioriser sur la mauvaise variable.
Mon premier réflexe, en venant du SEO, a été de construire une liste de mots-clés : une méthode qui ne fonctionne pas pour interroger un assistant IA.
Un mot-clé SEO décrit une chaîne de termes courte : « logiciel CRM », « chaussures randonnée ». Une requête adressée à un assistant IA décrit souvent un objectif, un contexte, des contraintes, parfois un rôle implicite. « Quel CRM choisir pour une PME industrielle avec une petite équipe commerciale ? » n'a ni la structure ni la fonction d'un mot-clé : construire un panier à partir d'un export SEO revient à mesurer la mauvaise chose.
Marketing Analytics CoE présente cette opposition comme une pratique répandue en GEO et AEO (answer engine optimization), pas comme une règle validée universellement. Dans mon expérience, un panier reconstruit à partir de mots-clés SEO sonne faux : il n'est pas formulé comme une vraie question.
Aucun chiffre ne fait consensus sur le nombre de requêtes à tester. TechBullion (2026) recommande 20 à 30 requêtes comme point de départ, à une condition quasi impérative : conserver exactement le même panier dans le temps. La tentation de modifier le panier en route pour « l'améliorer » coûte plus cher, en comparabilité, qu'un panier trop restreint au départ.
Le panier s'alimente à trois gisements : les questions réelles de clients et prospects (vocabulaire et objections effectifs), les « people also ask » des moteurs classiques (formulations déjà validées par un volume réel), et les formulations concurrentielles (comment un acheteur compare plusieurs options). Junto, dans sa méthode GEO en cinq étapes (16 septembre 2026), recommande de segmenter ce corpus par intention : empilé sans structure, il donne une moyenne qui ne veut rien dire.
Exemple. Pour l'éditeur de CRM, le panier mélange des questions de découverte (« qu'est-ce qu'un CRM »), des questions de comparaison directe (« quel CRM pour une PME industrielle ») et des formulations concurrentielles (« X ou Y pour une petite équipe commerciale »), gelées à 20-30 requêtes.
Livrable. Un panier figé de 20 à 30 requêtes, segmenté par intention, documenté et versionné.
Limites. Un panier conçu pour ChatGPT ne se transpose pas automatiquement aux autres moteurs sans vérification ; une formulation qui déclenche une recherche web sur l'un peut rester purement mémorielle sur l'autre (étape 4).
Insight. Un panier retouché en cours de route pour le rendre « meilleur » casse la comparabilité qu'on était venu chercher, bien davantage qu'un panier trop petit au départ.
Le panier ne vaut rien si l'échantillonnage est bancal : un panier parfaitement construit, interrogé une seule fois, retombe dans le piège de la première section.
Combien de tirages par requête. PeakView AI (10 juin 2026) recommande de répéter chaque requête plusieurs fois avec un contexte constant, puis de moyenner les résultats. Dans la pratique, 7 à 10 tirages indépendants par requête constituent une base exploitable, la fourchette documentée par cette source. Trois tirages, une convention personnelle non documentée ailleurs, suffisent pour un contrôle rapide, pas pour estimer un taux de citation avec une marge d'erreur acceptable. Pour une précision plus fine, rester dans le même ordre de grandeur documenté : jusqu'à 30 ou 100 tirages selon la rigueur recherchée.
| Paramètre | Valeur de base | Valeur de précision |
|---|---|---|
| Tirages par requête | 7 à 10 | 30 à 100 |
| Taille du panier | 20 à 30 requêtes | mêmes 20 à 30, gelées dans le temps |
| Fréquence de mesure | mensuelle | hebdomadaire ou bimensuelle |
La précision vient des tirages, pas de requêtes ajoutées au panier : élargir le panier change la couverture mesurée, pas la précision de chaque mesure.
Sessions neuves entre chaque tirage. Si la mémoire ou l'historique d'un assistant sont actifs, le modèle peut réutiliser des informations de conversations antérieures pour personnaliser la réponse suivante : on ne mesure plus alors la visibilité intrinsèque d'une marque, mais la capacité du système à se souvenir qu'elle a déjà été mentionnée dans la même session. GEO Monitor (28 septembre 2026) formule cette précaution comme une condition de validité : réinitialiser le contexte entre chaque tirage sépare une mesure d'un artefact de mémoire.
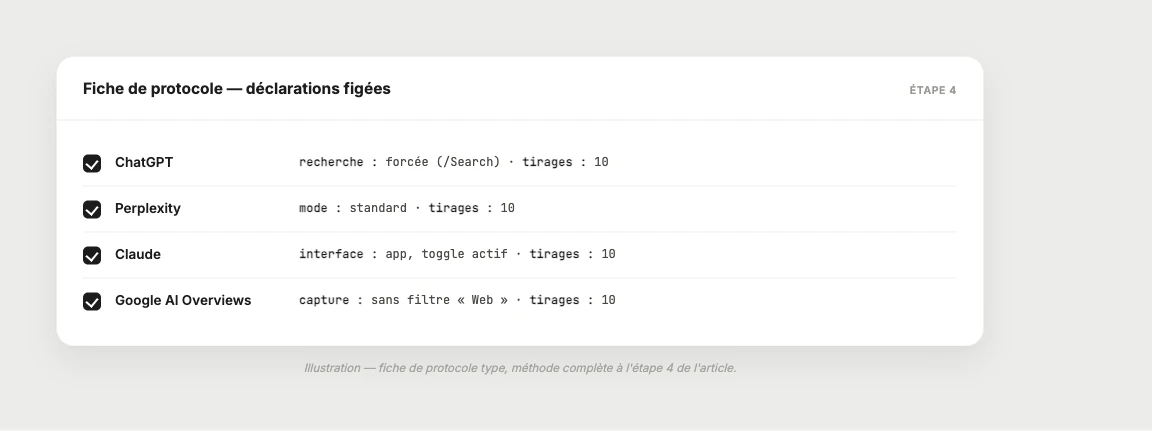
Ce que le protocole doit déclarer, moteur par moteur, puisque les sept systèmes couverts ici ne partagent pas la même mécanique de déclenchement :
/Search) ou la laisser au modèle, et le déclarer.Fréquence de ré-échantillonnage. Pas de norme universelle. Evocia (18 juillet 2026, mise à jour 15 octobre 2026) converge vers une cadence mensuelle comme base raisonnable ; en secteur instable, ou après une évolution majeure d'un modèle, un rythme hebdomadaire ou bimensuel devient préférable, le bruit de fond changeant de nature selon la volatilité.
Exemple. Pour l'éditeur de CRM, une capture ChatGPT précise si la recherche a été déclenchée automatiquement ou forcée ; une capture Copilot précise s'il s'agit du produit grand public ou de la licence entreprise des commerciaux.
Livrable. Une fiche de protocole par moteur retenu, avec paramètres figés (tirages, fréquence, mode, licence ou interface) et date de première mesure.
Limites. Un protocole figé peut devenir obsolète si un éditeur change sa mécanique par défaut (étape 9). Relire la fiche avant chaque nouvelle vague de mesure, pas seulement au lancement.
Insight. Ces sept déclarations déterminent, six mois plus tard, si une nouvelle mesure reproduit vraiment la précédente ou compare deux choses différentes sous le même nom de moteur.
Une méthode de relevé parmi d'autres. Constituer le corpus fixe, interroger chaque moteur avec la recherche activée selon le protocole de l'étape 4, extraire les citations affichées, dédupliquer et analyser les URL. D'autres approches existent, via du scraping tiers, avec des résultats parfois différents selon la méthode de collecte.
Ce que chaque moteur donne à extraire, documenté très inégalement :
Ce que révèle un relevé à grande échelle. Une analyse de Kevin Indig, Search Engine Land (24 mars 2026, mise à jour 14 septembre 2026), sur environ 1,2 million de réponses ChatGPT et près de 98 000 citations extraites, documente un biais de fond : ChatGPT cite moins de sources et privilégie l'institutionnel, Perplexity en cite davantage et diversifie plus largement.
Transformer le relevé en grille. Un relevé isolé ne sert pas à grand-chose : il devient utile converti en grille par requête, avec moteur, date, sources citées et lacunes identifiées. WPFormation (4 juin 2026) propose une démarche voisine, une méthode parmi d'autres, pas un consensus établi.
Mesurer la visibilité documente une fréquence, pas une cause : savoir qu'une marque est citée ne dit pas ce qui la produit. Les facteurs qui la produisent sont détaillés ailleurs : voir Comment être cité par ChatGPT, Perplexity et Gemini en 2026. Ce texte reste concentré sur le comment mesurer.
Exemple. 3 sources institutionnelles sur ChatGPT contre 11 domaines variés sur Perplexity, pour la même requête, ne dit rien sur qui est mieux cité : seulement sur la mécanique propre à chaque moteur.
Livrable. Une grille de relevé par requête × moteur × date, avec sources extraites et lacunes notées.
Limites. La grille doit rester aux variables indispensables à la comparaison ; les métadonnées enrichies (auteur, date de chaque source) sont facultatives et ne doivent pas devenir une charge disproportionnée quand l'interface ne les affiche pas de façon homogène.
Insight. ChatGPT et Perplexity citent différemment, pas seulement en volume : l'un privilégie l'institutionnel, l'autre diversifie. Un relevé qui ne distingue pas ces deux logiques de sélection risque de confondre « peu cité » avec « pas assez institutionnel », deux diagnostics qui appellent des actions différentes.
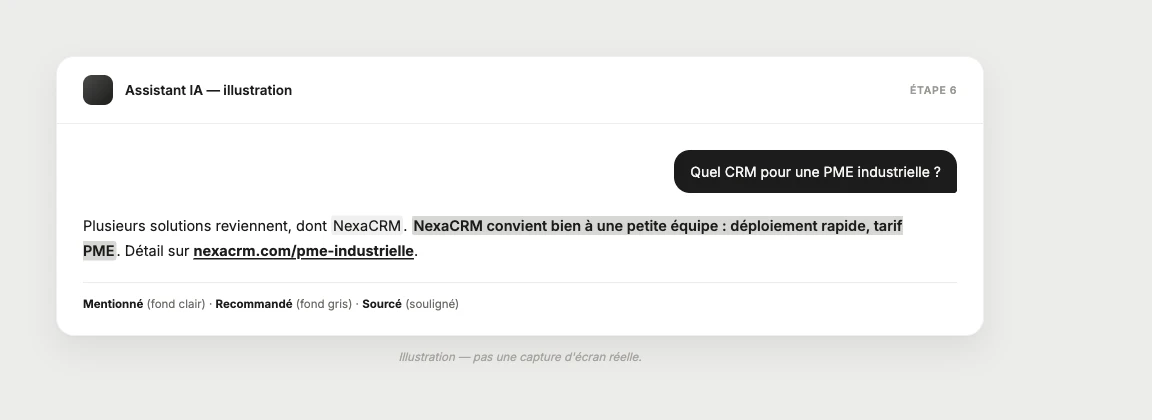
Une grille binaire, citée ou pas citée, ne suffit pas. Trois niveaux de lecture, mentionné, recommandé, sourcé, permettent une mesure plus fine, présentés ici pour ce qu'ils sont : des définitions opérationnelles, pas un standard reconnu de l'industrie.
Mentionné. Le nom de la marque apparaît explicitement dans la réponse, indépendamment d'un lien ou d'une recommandation active. GenerativeSearchEngine.fr (5 septembre 2026) retient ce même critère minimal : le niveau le plus simple à détecter, le moins informatif pris isolément.
Recommandé. La réponse propose activement la marque comme une option adaptée au besoin exprimé, dans une sélection ou un comparatif. Getmint (15 juillet 2026, mise à jour 11 octobre 2026) exige que la marque soit proposée comme pertinente pour l'intention exprimée, pas seulement citée en passant.
Sourcé. La marque est explicitement reliée à une information comme source : lien, référence, ou attribution identifiable à son domaine ou à un auteur. Terme non normalisé dans la littérature consultée, également signalé par Cicero Studio (9 mai 2026, mis à jour 15 octobre 2026) ; je l'utilise par commodité opérationnelle, en assumant qu'une autre équipe pourrait en retenir une définition différente.
| Niveau | Critère | Ce qu'il exclut |
|---|---|---|
| Mentionné | Le nom apparaît dans le texte de la réponse | Rien n'est présumé sur le sentiment ou l'intention de recommandation |
| Recommandé | Proposé activement comme solution adaptée au besoin | Une simple occurrence du nom sans contexte de choix |
| Sourcé | Relié explicitement à une attribution : lien, auteur, référence | Une mention sans trace documentaire identifiable |
Un niveau qui ne se compare pas à paramètres constants entre moteurs. Sur Perplexity, où chaque réponse cite systématiquement ses sources par construction, le taux de « sourcé » sera structurellement élevé, quel que soit le contenu mesuré. Sur un moteur où la citation reste conditionnelle, comme ChatGPT ou Gemini en usage grand public, le même taux mesure un effort réel de sourcing. Les comparer sans déclarer le mode utilisé (étape 4) revient à comparer deux instruments différents.
Un classificateur, même simple, force à rendre explicite la règle de décision plutôt que de trancher à l'œil réponse par réponse :
import re

RECO_CUES = [r"\boption (bien )?adapt(é|ée)e?\b", r"\brecommand(e|é|ée)\b", r"\bidéal(e)? pour\b"]

def classify(response_text: str, brand: str) -> str | None:
    if brand.lower() not in response_text.lower():
        return None  # absente : pas de niveau
    has_source = bool(re.search(rf"{re.escape(brand)}\S*\.(com|fr|io)", response_text, re.I))
    if has_source:
        return "sourcé"
    if any(re.search(p, response_text, re.I) for p in RECO_CUES):
        return "recommandé"
    return "mentionné"

niveaux = [classify(r, brand="NexaCRM") for r in tirages]  # tirages : étape 4
taux = {lvl: niveaux.count(lvl) / len(niveaux) for lvl in ("sourcé", "recommandé", "mentionné")}
Exemple. Mentionnée dans 120 réponses, recommandée dans 40, sourcée dans 15 seulement, sur 200 tirages : trois taux très différents, le plus bas ne prédisant pas le plus exigeant.
Livrable. Un taux par niveau (mentionné, recommandé, sourcé) et par moteur, calculé sur l'ensemble des tirages d'un cycle de mesure.
Limites. Ces trois niveaux restent des conventions de travail, utiles pour comparer un mois sur l'autre à l'intérieur d'un même protocole cohérent, pas pour trancher un débat terminologique qui, dans la littérature GEO et AEO, n'est pas encore clos.
Insight. Sur Perplexity, un taux de « sourcé » élevé découle d'abord de la mécanique de citation systématique du moteur, avant même de dépendre du contenu de la marque mesurée.
Une corrélation modérée. Une étude Ahrefs du 12 décembre 2025, « Top Brand Visibility Factors in ChatGPT, AI Mode, and AI Overviews », portant sur 75 000 marques, mesure pour ChatGPT une corrélation de Spearman de 0,352 entre le volume de recherches de la marque et sa visibilité dans les réponses IA : un signal à prendre en compte, insuffisant à lui seul pour prédire une visibilité à partir d'un indicateur unique.
Un sens de causalité qui reste ouvert. La notoriété préexistante d'une marque explique probablement une part de sa visibilité : une marque déjà connue a mécaniquement plus de chances d'être citée. L'inverse mérite tout autant d'attention : être exposé dans une réponse IA peut créer de la demande différée, avec un effet probablement décalé dans le temps et difficile à isoler des autres facteurs. Une étude publiée sur arXiv le 15 juin 2026 (Baig, Gillani et Ali) teste par audit randomisé l'effet causal de signaux de réputation sur la probabilité qu'un hôtel soit recommandé par une IA : un des rares tests causaux publiés à ce jour, sur un périmètre voisin du GEO plutôt que généralisable à toute marque. Au-delà de ce cas précis, la causalité générale reste non tranchée dans la littérature disponible, dans un sens comme dans l'autre. Prudence recommandée pour quiconque vend le GEO comme un levier de demande garanti.
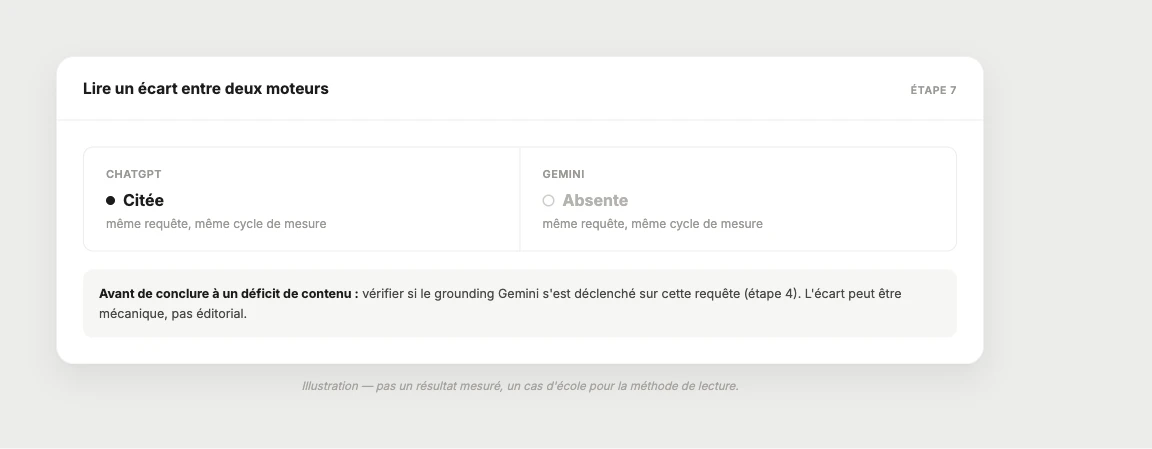
Lire l'écart entre deux moteurs. Un écart entre deux moteurs sur la même marque n'est pas automatiquement un problème à corriger : il peut refléter une différence réelle de mécanique de sélection des sources (étape 5), pas un déficit de contenu. Avant de conclure à un problème de visibilité, vérifier si l'écart persiste sur plusieurs cycles de mesure consécutifs, pas sur un seul relevé.
Exemple. Bien citée sur ChatGPT, absente sur Gemini pour les mêmes requêtes : vérifier d'abord si le grounding Gemini s'est déclenché avant de conclure à un vrai déficit de visibilité.
Livrable. Pour chaque écart significatif détecté, une fiche qui distingue ce qui relève d'un déficit de contenu probable, d'une différence de mécanique entre moteurs, ou d'un signal encore trop bruité pour trancher.
Limites. Une corrélation observée sur un secteur ou un marché ne se transpose pas automatiquement à un autre ; l'étude Ahrefs porte sur 75 000 marques tous secteurs confondus, pas sur un secteur donné.
Insight. Avant de corriger côté marque, vérifier que l'écart ne vient pas de la mécanique propre du moteur (étape 4) : une action sur le mauvais levier ne change rien à la mesure suivante.
Un écart mesuré ne vaut rien tant qu'il ne débouche pas sur une action priorisée. Trois critères suffisent pour classer un backlog d'actions GEO sans sur-outiller la démarche : le volume de la requête ou de l'intention concernée, l'écart à la marque la mieux citée sur ce même panier, et la facilité réelle de l'action identifiée.
Pour l'éditeur de CRM, un écart constaté sur la requête « quel CRM pour une PME industrielle » pèse plus qu'un écart sur une requête de niche testée une seule fois dans le panier : le volume justifie l'investissement. Si l'écart recoupe un contenu manquant identifiable, une page de comparatif qui n'existe pas, l'action est concrète et rapide. Si l'écart relève d'une notoriété de marque encore faible, aucune action de contenu ne le corrigera à elle seule.
Les facteurs qui produisent la visibilité dépassent le périmètre de ce texte, centré sur la mesure : voir la référence citée à l'étape 5.
Livrable. Un backlog d'actions trié par volume, écart et facilité, relié à chaque fiche d'écart produite à l'étape 7.
Limites. Prioriser sur ces trois critères suppose que le volume de requête mesuré dans le panier reflète un volume réel ; un panier mal segmenté (étape 3) fausse cette priorisation en amont.
Insight. Un backlog GEO qui ne distingue pas un écart corrigible par du contenu d'un écart qui tient à la notoriété produit des actions dont l'effet ne peut jamais être mesuré proprement, puisqu'on ne sait pas, a priori, lequel des deux facteurs domine.
Suivre une marque suppose aussi de vérifier que les plateformes mesurées restent les mêmes objets d'une vague à l'autre : les systèmes eux-mêmes bougent.
Deux exemples, sur la seule période couverte ici. Google a cessé, mi-2026, de communiquer un chiffre d'utilisateurs séparé pour AI Overviews, fusionnant son discours avec AI Mode : un protocole qui aurait continué à traiter les deux comme strictement séparés aurait suivi une distinction en train de s'effacer. Microsoft, de son côté, a fusionné en cours d'année le nommage de ses produits Copilot grand public et entreprise : une mesure « Copilot » lancée avant ce changement et poursuivie après, sans le noter, mélangerait deux populations.
Un même protocole, reconduit à deux mois d'écart avec le même panier, peut produire des écarts qui ne s'expliquent pas entièrement : le modèle change, la récupération d'information change, le web change. La variation ne signifie pas un protocole peu reproductible, elle peut signaler une évolution réelle du système mesuré.
Livrable. Une note de vigilance produit tenue à jour à chaque cycle de mesure, qui consigne tout changement de nommage, de mécanique par défaut ou de communication officielle détecté sur l'un des moteurs suivis.
Limites. Cette vigilance ne peut reposer que sur une veille active ; aucun des éditeurs couverts ici ne notifie les praticiens GEO d'un changement de mécanique, il faut le détecter de l'extérieur.
Insight. Un chiffre continue de sortir d'un protocole « reproductible » même quand l'objet mesuré a changé de nature entre deux cycles : la vigilance de cette étape existe pour repérer ce décalage avant qu'il ne fausse une comparaison.
Une mesure de visibilité reste une fréquence observée sur un corpus de requêtes, de comptes et de moments donnés, bien en-deçà d'une mesure exhaustive de l'exposition réelle de tous les utilisateurs. Auspia (17 septembre 2026) le formule sans détour : un indicateur expérimental, une fréquence qui se reconduit et se réinterprète à chaque nouvelle mesure. Un panier trop petit, ou mal segmenté entre les intentions, produit un biais d'échantillonnage : une fausse impression de stabilité, simplement parce qu'il ne couvre pas assez de situations réelles pour que les variations se neutralisent.
Deux problèmes de fond restent sans réponse établie : l'opacité de l'attribution des citations (on sait rarement pourquoi un moteur choisit telle source) et la faible reproductibilité dans le temps, documentée à l'étape 9. Un rapport Semrush sur la visibilité IA, publié en 2026, relaie ce même constat d'une littérature encore non stabilisée.
Une limite plus large dépasse la seule mesure d'une marque : aucun des éditeurs couverts dans ce texte ne publie l'indicateur qui compterait le plus pour une méthode comparative, une part de requêtes sur base homogène entre moteurs. Google a explicitement contesté une étude Pew Research sur ce point sans publier de contre-mesure chiffrée. Toute part de marché « IA » qui circule dans la presse GEO est une reconstruction tierce, à citer avec sa méthode nommée, jamais comme un chiffre officiel interchangeable.
Je ne prétends pas que le protocole décrit ici résout ces inconnues. Il les rend visibles et quantifiables, ce qui n'est déjà pas rien quand la norme du marché reste la capture d'écran brandie sans contexte.
La visibilité dans les moteurs IA se mesure. Mais seulement comme une fréquence observée sur un protocole donné et déclaré, moteur par moteur, jamais comme une vérité stable, et encore moins comme une capture d'écran qu'on brandit sans préciser ni le panier, ni le nombre de tirages, ni la date du relevé, ni le moteur exact mesuré.
Erlé, fondateur omkomunity.ai
L'auteur
Erlé Alberton
Fondateur de OMKomUnity. Pilote agence et conseil sur SEO, GEO, architecture martech et orchestration IA marketing — studio pour l'exécution, expertise personnelle pour le cadrage, sans complexité inutile ni surcoût structurel.
Pour continuer
Une sélection, pas un flux : ce qui change quelque chose, et pourquoi.
À lire aussi
21 agences et 3 outils de monitoring GEO en France, relevé du 15 octobre 2026 sur leur propre site : moteurs IA couverts, méthode, tarif. OMKomUnity inclus.
Search Console ne voit rien de ce qui se passe dans ChatGPT, Perplexity ou Gemini. Ce qu'on peut effectivement vérifier, mesurer, comparer, et ce qu'aucune mesure ne montre encore.
La plupart des guides GEO 2026 recommandent la même checklist générique. Sept études datées disent autre chose : ce qui corrèle vraiment avec la citation par une IA n'est pas ce qu'on vous vend.
Nous utilisons des traceurs de mesure d’audience et de publicité. Vous pouvez les accepter, les refuser, ou choisir finalité par finalité — le site fonctionne identiquement dans tous les cas. En savoir plus